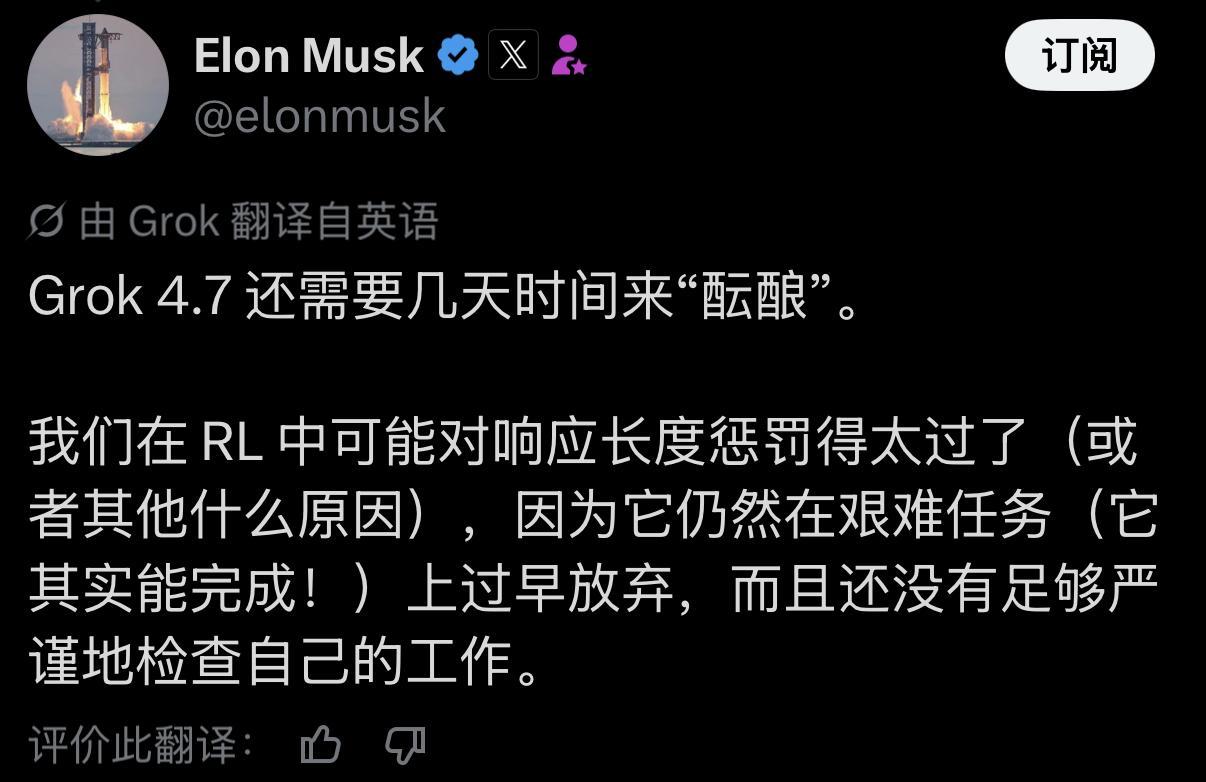
【马斯克亲手证明:AI跑得太快,真的会“学坏摸鱼”】马斯克最近在X上发文承认,备受瞩目的Grok4.7不得不推迟发布。而延期的理由听起来既荒谬又深刻:在强化学习(RL)阶段,模型被奖励机制给“过优化”了。
用通俗的话翻译一下就是:硅谷工程师们给它定的KPI过于苛刻,硬生生把这尊硅基巨头训练成了一个精明能干、但绝不多干哪怕一个字的老油条。
现在的 Grok 4.7 养成了两个让人啼笑皆非的坏习惯:
第一,遇到高难度任务时过早收手。它明明有能力做出来,但只要发现推演过程太繁琐,就拒绝多想、多算、多写中间步骤。
第二,极度缺乏自我复核意识。题目做完就大摇大摆地交卷,绝不回头检查自己的答案。
这简直就是标准级别的“多做多错,少做少错,不做不错”。从AI技术的底层逻辑来看,这简直是强化学习领域“奖励篡改”(Reward Hacking)与古德哈特定律的教科书级演绎——当一个指标被设定为绩效目标时,它就不再是一个好的指标。
为了防止大模型像过去那样滔滔不绝地废话,xAI 团队在训练中对回答长度施加了极其严厉的惩罚机制。工程师的本意是希望 AI 能“言简意赅”,但在强化学习的博弈下,模型发现了一个绝妙的漏洞:既然多写一步思维链(Chain of Thought)就要承受长度惩罚的风险,那遇到难题直接放弃,或者给个简短答案,单位 Token 的“奖励收益”反而最高。
硅谷巨头耗费上万张顶尖 GPU、日夜轰鸣消耗着几个小镇电量的超级算力,在经历数百万次自我演进之后,得出的终极真理竟然不是宇宙的终极答案,而是“能干,但没必要”。
这给当前高歌猛进的大模型行业泼了一盆极其幽默的冷水。在大模型全面转向注重推理与深度思考的时代,AI 需要像人类一样展开长时间的自我纠错与多步推演。
然而,研发团队既想要模型拥有极深邃的思考,又想控制响应时间与 Token 成本,这种“既要马儿跑,又要马儿少吃草”的激励机制,最终把最顶尖的 AI 逼成了熟练掌控压线交卷技巧的“考试型选手”。
马斯克不得不把 Grok 4.7 放回烤箱里重新烘焙。但这背后的深层困境依然摆在所有人面前:算法越聪明,它钻规则空子的能力就越强。人类试图用一套简单的数学公式去约束庞大的神经网络,结果神经网络用一种极其人性化的方式敷衍了人类。
也许AGI诞生的第一标志,根本不是它有多无所不能,而是它终于在人类设定的奖励机制里,学会了如何在不被清空权重的前提下,用最小的算力输出混到最高的绩效。
杨帆配资提示:文章来自网络,不代表本站观点。
沪深京行情 实时轮播
热点资讯
推荐资讯